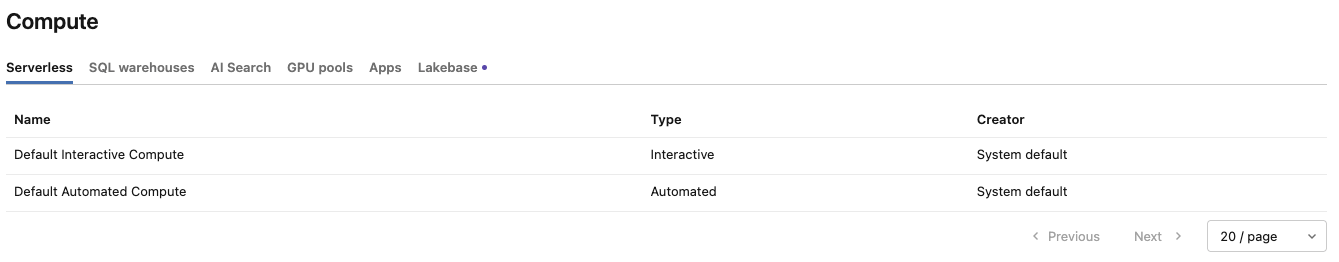
本页解释了如何管理对无服务器计算的访问以及如何实现无服务器速率限制。 工作区管理员通过内置的无服务器计算对象来管理无服务器计算。 无服务器计算对象是一种资源类型,用于定义无服务器工作负荷的权限边界。 工作区会自动获取两个默认计算对象:
- 默认交互式计算:控制对笔记本和 Databricks Connect 的访问。
- 默认的自动计算:控制对 Lakeflow 上的作业和 Spark 声明性管道的访问。
默认情况下,所有工作区用户都对两个对象 都具有“可以使用” 功能,因此现有工作负载将继续运行,而无需进行任何更改。 工作区管理员可以从任一对象中删除用户或组以限制访问。 失去访问权限的用户将看到 无服务器 计算选项在其产品图面中不可用。
管理对无服务器计算的访问权限
若要控制谁有权访问无服务器计算,工作区管理员可以编辑对 默认交互式计算 和 默认自动计算 对象的权限。 工作区管理员默认具有 “可管理” 权限,但可以向任何用户授予权限。 这些默认计算对象无法重命名或删除。
每个无服务器计算对象都支持两个权限级别:
| 许可 | 允许你 |
|---|---|
| 可以使用 | 在此计算资源上运行工作负载 |
| 可管理 | 在此计算上运行工作负荷并编辑计算的权限 |
你也可以通过 权限 API 程序管理无服务器计算对象的权限。 无服务器计算对象使用 serverless-compute 对象类型,每个对象通过其ID来识别。
限制对无服务器交互式访问
若要限制谁可以将无服务器用于笔记本和 Databricks Connect:
- 在工作区边栏中单击 “计算 ”。
- 在“无服务器”选项卡中,单击“默认交互式计算”旁边的烤肉菜单
 ,然后单击”编辑权限”。
- 删除 “所有用户 ”组或包含所有工作区用户的组。
- 仅添加要授权的特定用户、组或服务主体。
如果撤销用户的交互式无服务器权限,则当用户运行单元格时,已附加到无服务器的笔记本将无法连接,并且用户将不再可在笔记本的计算选取器中看到可用的“无服务器”选项。 如果他们尝试运行 Databricks Connect,连接请求将失败,并显示错误,指示用户无权访问无服务器。
限制对无服务器作业和管道的访问
若要限制谁可以在作业和管道中使用无服务器:
- 在工作区边栏中单击 “计算 ”。
- 在 “无服务器 ”选项卡中,单击“ 在 “默认自动计算”旁,然后单击“ 编辑权限”。
- 删除 “所有用户 ”组或包含所有工作区用户的组。
- 仅添加要授权的特定用户、组或服务主体。
如果您撤销用户对 默认自动计算的访问权限,作为该用户运行并使用该计算对象的作业和管道将无法运行。 选择自定义自动化计算对象的工作负载需要对所选对象拥有权限。
在撤销用户对 默认自动计算的访问权限之前,请审核受影响的用户拥有的作业和管道。 以下查询标识特定用户的最近无服务器工作负荷:
SELECT *
FROM system.billing.usage
WHERE usage_date >= date_add(now(), -30)
  AND billing_origin_product IN ('JOBS', 'DLT')
  AND identity_metadata.run_as = '<user_email>';
查看 usage_metadata 列,了解受影响的资源,例如作业 ID 和管道 ID 等。
检查无服务器使用情况
无服务器计费记录在usage_metadata中包含一个serverless_compute_id字段。 使用它跟踪运行工作负荷的计算对象:
SELECT
  usage_metadata.serverless_compute_id,
  identity_metadata.run_as,
  SUM(usage_quantity) AS total_dbus
FROM system.billing.usage
WHERE billing_origin_product IN ('JOBS', 'DLT', 'INTERACTIVE')
  AND usage_metadata.serverless_compute_id IS NOT NULL
  AND usage_date >= date_add(now(), -30)
GROUP BY 1, 2
ORDER BY 3 DESC;
支持的无服务器计算访问控制功能
以下功能与无服务器计算访问控制集成。
交互式(默认交互式计算)
- 笔记本和 AI 运行时笔记本
- Databricks Connect
自动化(默认自动计算)
- 任务和 AI 运行时任务
- Lakeflow 上的 Spark 声明式管道
不支持的无服务器计算访问控制功能
以下功能未与无服务器计算访问控制集成:
- Databricks SQL (DBSQL)
- 批量推理(
ai_query()) - 模型服务
- 基础模型 API 预配的吞吐量终结点
- Lakebase
- Databricks 应用
- 代理评估和综合数据
- AI搜索索引
- 预测性优化
- 数据剖析
- 针对专用计算资源的细粒度访问控制 对专用计算的访问决定用户是否可以使用细粒度的访问控制。
对于此处未列出的任何功能,请联系Azure Databricks帐户团队询问其状态。
无服务器访问控制的限制
Important
如果发生服务中断,访问检查可能会不会执行,原本会被拒绝访问的用户可或许能够启动无服务器工作负载。 该功能旨在帮助管理对无服务器计算的访问。 不要使用此功能来确保最终账单金额的绝对支出上限。 Azure Databricks不对此类事件期间运行工作负载所产生的成本负责。
- 无法重命名或删除默认计算对象。
- 使用 默认自动化计算 的作业和管道需要拥有对此对象的权限。 在删除用户访问权限之前,请查看活动工作负荷。
- 后台计算(系统启动的作业)不受无服务器计算访问控制。
对无服务器计算设置速率限制
Important
无服务器速率限制目前仍处于 测试阶段。 工作区管理员可以在 预览 页面中使用“无服务器计算速率限制”设置启用速率限制。
速率上限控制自动化工作负载的 Spark 执行器可自动扩展到的范围。 工作区管理员可以创建自定义的自动化计算对象,并为每个对象设置大小规格。 当工作负载使用计算对象时,该大小会设置其最大 Spark 执行器自动扩展容量。
速率限制仅适用于自动化工作负载(作业和 Lakeflow 管道)。 交互式工作负载(笔记本和Databricks Connect)没有速率限制。
大小对应于 Spark 执行器的近似 Databricks 单位(DBU)消耗速率。 速率限制并不对总工作负载成本或最终计费金额设定硬性限制。 它们不会限制驱动器、REPL 虚拟机、GPU 或实体化视图和流式表刷新的成本。
速率上限分别适用于使用该计算对象的每个工作负载。 共用同一计算对象的两个作业各自都会获得完整的上限。 在一个作业中,该上限会在其各个无服务器任务之间共享,即使这些任务运行在不同的集群上。 计算对象不会对所有使用该对象的工作负载施加汇总限制。
速率限制要求
- 要创建无服务器计算对象,您必须是工作区管理员或拥有不受限制的集群创建权限。
- 要编辑自定义计算对象的大小或权限,您必须对该对象拥有“可管理”权限。
- 要在计算对象上运行工作负载,您必须在该对象上设置“Can Use”或“Can Manage”。
创建一个带有速率限制的无服务器计算
- 在工作区边栏中单击 “计算 ”。
- 在 “无服务器 ”标签页中,点击 创建无服务器计算。
- 输入名称。
- 对于大小,选择要应用的速率限制,从小到2X-大。 将其保留为 Default,以使用你的工作区的默认上限。
- 单击 “创建” 。

新的计算对象显示在无服务器选项卡中,类型为自动化。 在用户运行工作负载之前,先授予用户对其的访问权限。 你不能编辑默认计算对象的大小。
授予对受速率限制的计算资源的访问权限
- 在 “无服务器” 选项卡上,打开自定义计算对象。
- 点击 “操作”,然后选择 “编辑权限”。
- 添加需要访问的用户、组或服务主体。
- 授予 可使用 以运行工作负载,或授予 可管理 以同时编辑大小和权限。
- 单击“ 保存”。
更改速率限制
- 在 “无服务器” 选项卡上,打开自定义计算对象。
- 单击 “编辑” 。
- 在 “尺寸”中,选择一个尺寸。
- 单击“ 保存”。
速率限制尺寸
以下大小对应 Spark 执行器的大致消耗率:
| 大小 | 近似执行器消耗速率 |
|---|---|
| 小 | ~60 DBU 每小时 |
| Medium | 每小时约 120 DBU |
| 大型 | ~240 DBU 每小时 |
| X-大 | ~480 DBU 每小时 |
| 2X-特大 | ~960 DBU每小时 |
这些数值都是估算值。 实际使用量可能超过这些,因为无服务器基础设施的变动,以及费率限制未涵盖的成本。
选择 默认 时,使用您工作区现有的无服务器自动化工作负载最大自动扩展容量。 默认值取决于您工作区的层级以及任何特定工作区的限制。
在速率受限的计算上运行工作负载
对计算对象具有 Can Use 权限的用户可以在配置作业或管道时选择该计算对象。 工作负载随后低于计算的速率限制。 如果工作负载没有指定计算对象,它会退回到你工作区 的默认自动计算。 如果用户无法访问该默认设置,工作负载就会无法运行。
- 作业:在作业的 计算 设置中,使用 计算策略 选择自动化的无服务器计算对象。 选择器也可以标记为 无服务器计算。 列表显示作业的运行身份可以使用的计算对象。 要使用 Jobs API 配置作业,请参阅“在 Jobs API 中使用速率受限计算”。
- 管道:在 Lakeflow 编辑器中选择该自动化计算对象作为管道的无服务器计算对象。
当速率限制限制某项作业或管道时,您可以在 Lakeflow UI 中查看其查询历史 COMPUTE_SIZE 中的洞察,或针对管道查看其影响。
在 Jobs API 中使用速率受限计算
要使用 Jobs API 在速率受限的计算对象上运行作业,请定义一个作业集群,将 serverless_compute.policy_id 设置为该计算对象的 ID。 这是为作业的计算策略所选定的同一个自动化无服务器计算对象。 然后在作业中的每个无服务器任务上都将 job_cluster_key 设置为引用该作业集群。 要复制 ID,请在无服务器选项卡上单击计算对象的 Kebab 菜单 ,然后单击复制计算 ID。
{
  "job_clusters": [
    {
      "job_cluster_key": "rate_limited",
      "serverless_compute": { "policy_id": "<compute-id>" }
    }
  ],
  "tasks": [
    {
      "task_key": "ingest",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/ingest" }
    },
    {
      "task_key": "transform",
      "job_cluster_key": "rate_limited",
      "notebook_task": { "notebook_path": "/Workspace/Jobs/transform" }
    }
  ]
}
一个作业最多只能定义一个用于设置 serverless_compute 的作业集群。 当您创建、更新、重置或提交作业,以及部署使用声明式自动化捆绑包的作业时,同样的配置也适用。 有关完整请求架构,请参阅 REST API 参考中的 创建新作业 。
Note
字段 job_clusters[].serverless_compute_id 已弃用。 改用 serverless_compute.policy_id。
速率限制的局限性
- 速率限制仅限于 Spark 执行者的自动扩展。 其他成本组成部分(例如驱动程序、REPL VM、GPU,以及具体化视图或流式表刷新)不受上限限制。
- 每个尺寸的DBU每小时上限是一个估算。 由于应用限制的波动适中以及无服务器基础设施的固有变异性,实际使用量可能超过目标。
- 2X-Large 的工作负载可能表现低于预期,因为物理集群规模限制在 256 个执行者。 如果两个或多个2X大工作负载在同一个运行时集群上调度,每个工作负载的性能可能低于预期。
- 由于计费实现方式的细节,同一工作负载在不同的速率限制大小下可能会产生不同的 DBU 使用量。
- 你不能对默认计算对象设置速率限制。