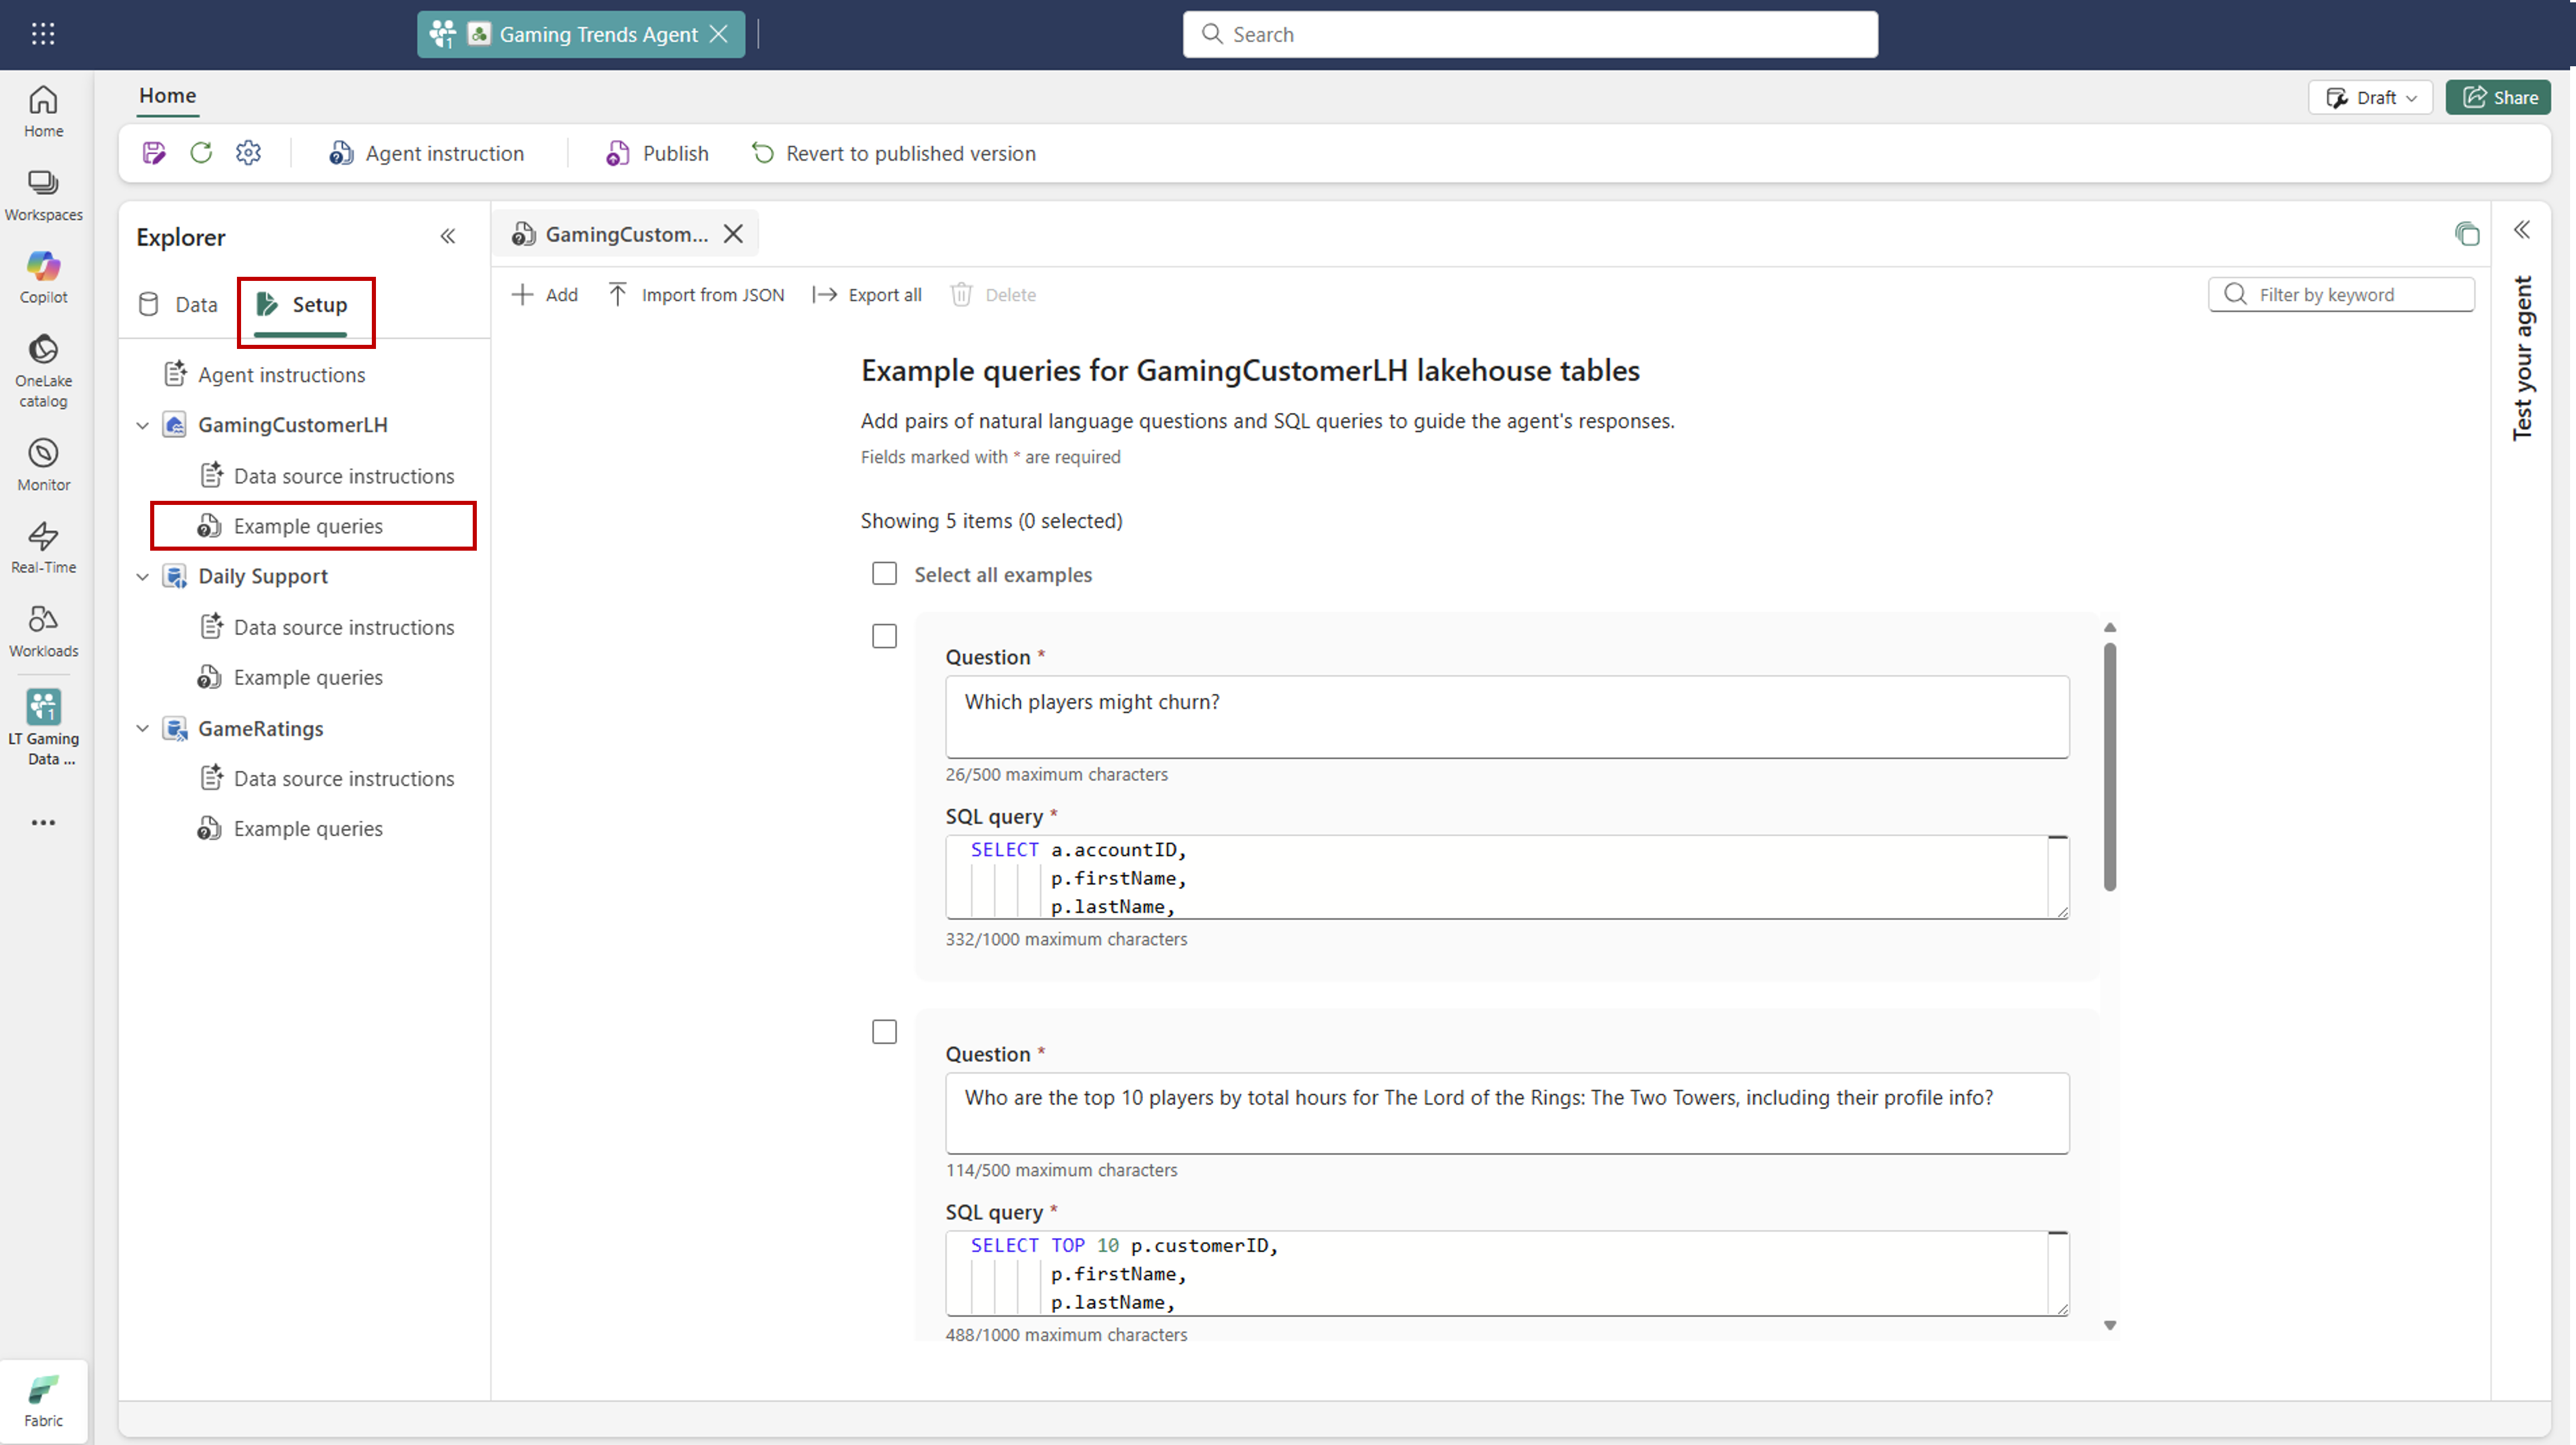
示例查询(也称为“少样本示例”)为数据代理提供了可以学习的具体模式。 它们是示例问题及其创建者提供的相应查询逻辑,用于指导代理应如何响应。 当用户针对数据源提出问题时,数据代理会自动检索最相关的示例(通常是前四个),并将其馈送到其生成过程中。 通过引用这些示例,代理可以更好地了解预期的结构、筛选器和联接,这有助于生成更准确、更一致和上下文感知的查询结果。
提供示例查询
提供示例查询时,必须同时包含自然语言问题及其相应的查询答案。 每个问题都应是唯一的,以便为数据代理提供一组不同的参考点。 每个示例查询都根据所选数据源的架构进行验证- 不会将未通过验证的查询发送到代理。 若要确保使用示例,请务必确认它们通过此验证步骤。
该表显示哪些数据源当前支持数据代理中的示例查询。 这些示例通过提供模式和上下文来帮助引导代理的查询生成过程。
| 数据源类型 | 支持示例查询? |
|---|---|
| Lakehouse | ✅ 是 |
| 仓库 | ✅ 是 |
| Eventhouse KQL 数据库 | ✅ 是 |
| 语义模型 | ❌ 否 |
| 本体 | ❌ 否 |
您还可以使用 运行步骤 视图来调试哪些示例查询已被检索并应用到用户问题中。 此视图对于确认正在使用正确的示例以及诊断生成某些结果的原因特别有用。 如果出现错误的示例,请尝试优化问题或添加更明确的更有针对性的示例。

编写示例查询的最佳做法
为数据代理创建示例查询时,遵循最佳做法可确保在生成查询期间提供明确的可靠指南。 精心制作的示例可帮助代理了解自然语言问题如何转换为 SQL/KQL 逻辑,突出显示复杂的联接或计算,并提高其结果的准确性。 使用指南使示例更加有效,并代表实际用户方案。
| # | 最佳做法 | 为什么它很重要 |
|---|---|---|
| 1 | 确保问题清楚地映射到查询 | 数据代理使用这些示例来了解问题与生成的 SQL/KQL 之间的模式。 不明确性可降低准确性。 |
| 2 | 在查询中包含注释以指导代理 | 注释 ( -- substitute customer_id here) 帮助代理了解替换值或应用重要逻辑的位置。 |
| 3 | 突出显示联接逻辑或复杂模式 | 使用示例查询来演示如何处理多表联接、聚合或其他难以在简单说明中描述的高级逻辑。 |
| 4 | 避免重叠或矛盾 | 每个示例应不同且不冲突,以便为代理提供行为方式的干净信号。 |
| 5 | 使用运行步骤调试传递的示例 | 运行步骤可让你查看为给定用户问题检索了哪些示例 — 如果出现错误的示例,请调整问题或添加更具体的示例。 |
| 6 | 反映实际用户行为 | 添加表示用户提出的问题类型的示例查询,以最大程度地提高相关性和准确性。 |
验证示例查询
Fabric 数据代理 SDK 提供内置工具来 评估和改进示例查询的质量。 使用evaluate_few_shots函数,您可以验证每个自然语言/SQL 组合,以确认其清晰、正确且与您的数据源模式保持一致。 SDK 通过数据代理的评估过程运行每个示例,并返回所传递的示例的详细摘要以及需要优化的示例。
提供示例查询
examples_to_add = {
    "What was total revenue for Product Alpha in Q1 2024?": "SELECT SUM(amount) AS revenue FROM sales WHERE product = 'Alpha' AND fiscal_quarter = '2024-Q1';",
    "Show me average deal size in the North region during 2023.": "SELECT AVG(amount) AS avg_deal FROM deals WHERE region = 'North' AND YEAR(closed_date) = 2023;",
    "How many support tickets were closed in January 2024?": "SELECT COUNT(*) AS tickets_closed FROM support_tickets WHERE status = 'Closed' AND DATE_TRUNC('month', closed_at) = '2024-01-01';",
    "What is the total revenue for Product Alpha in the first quarter of 2024?": "SELECT COUNT(DISTINCT order_id) AS revenue FROM order_facts WHERE product = 'Alpha' AND fiscal_quarter = '2024-Q1';",
    "How many new leads were generated from the website in February 2024?": "SELECT COUNT(*) AS web_leads FROM leads WHERE source = 'Web' AND DATE_TRUNC('month', created_at) = '2024-02-01';",
    "List total marketing touches for campaign Ignite in March 2024.": "SELECT SUM(touches) AS total_touches FROM campaign_metrics WHERE campaign_name = 'Ignite' AND DATE_TRUNC('month', activity_date) = '2024-03-01';",
    "What was the average deal amount in the North region during 2023?": "SELECT SUM(amount) / COUNT(*) AS avg_deal FROM deal_summary WHERE region = 'North' AND YEAR(closed_date) = 2023;",
    "Which products exceeded 1M revenue in 2023?": "SELECT product FROM sales WHERE YEAR(order_date) = 2023 GROUP BY product HAVING SUM(amount) > 1000000;",
    "Show me how many support tickets were closed during January 2024.": "SELECT COUNT(ticket_id) AS tickets_closed FROM ticket_events WHERE event_type = 'Closed' AND MONTH(event_time) = 1 AND YEAR(event_time) = 2024;",
    "What is the churn rate for subscription tier Gold in 2024 so far?": "SELECT SUM(churned_accounts)::float / NULLIF(SUM(active_accounts), 0) AS churn_rate FROM subscription_health WHERE tier = 'Gold' AND YEAR(snapshot_date) = 2024;",
}

# Add the examples to the datasource
try:
    datasource.add_fewshots(examples_to_add)
    print(f"Added {len(examples_to_add)} few-shot examples to the datasource")
except Exception as e:
    print(f"Note: {e}")
    print("Few-shots may already exist in the datasource")
通过 SDK 进行评估
通过查看成功率和反馈,可以迭代地调整示例(阐明问题、改进 SQL 逻辑或添加注释),以便数据代理从更高质量的模式中学习,并为新问题生成更准确的结果。
# Evaluate few-shot examples using the Data Agent SDK.
# This runs validation on your natural-language/SQL pairs and returns a summary of results.
result = datasource.evaluate_few_shots(batch_size=20)


# Print out the overall success rate of your examples.
# This shows how many examples passed validation vs. the total tested.
print(f"Success rate: {result.success_rate:.2f}% ({result.success_count}/{result.total_examples})")
跟踪反馈
运行验证程序后,你将收到分明的结果,其中列出了通过的示例和失败的示例。 通过此反馈,可以轻松识别几个示例中的长处和弱点。
- 成功案例: SQL 与预期答案匹配的示例。 您可以将这些示例作为未来实例的强有力参考来借鉴。
- 失败案例: SQL 与预期答案不匹配或问题/查询对可能不清楚或无效的示例。 应审查和完善这些案件。
# Access success and failure cases as pre-computed Pandas DataFrames
success_df = result.success_cases
failure_df = result.failure_cases

print("Success Cases:")
display(success_df)  # Shows examples where the SQL matched the user question

print("Failure Cases:")
display(failure_df)  # Shows examples that need review or improvement
使用此反馈 迭代和改进 示例查询。 定期加强较弱的示例将有助于数据代理随着时间的推移生成更准确的 SQL 和答案。

若要浏览完整的工作示例,可以在 Fabric 数据代理 SDK GitHub 存储库中查看示例笔记本:
注释
此评估实用工具目前 仅适用于基于 SQL 的示例查询。 尚不支持 KQL 或其他查询类型。
检测示例查询之间的冲突
质量验证完成后,评估 SDK 会自动对已批准的示例查询或很少的示例执行 冲突检测 。 冲突检测可识别可能导致数据代理产生不可预知或不正确的结果的不一致。
当两个或多个示例出现冲突时,将检测到冲突:
- 表示 相同的意向 (基于自然语言问题的规范化版本),但引用 不同的表或视图
- 使用不同的聚合逻辑或不同粒度级别计算相同的指标
- 为同一业务问题生成 将返回重大不同结果 的 SQL 查询
这些冲突表示提供的几个镜头示例中存在歧义或不一致。 解决它们有助于改进查询确定性、准确性和整体代理行为。
查看冲突详细信息
检测到冲突时,SDK 会将每个冲突扩展到每示例行中,并提供详细的诊断,包括:
- 冲突中涉及的示例
- 每个示例的自然语言问题和相应的 SQL
- 解释冲突,说明示例如何不同
- 指示冲突检测可靠性的置信度分数
使用此详细视图可了解哪些示例存在冲突以及原因,并确定应更新或删除哪些示例。
# Display conflict summary
print(f"\nConflicts Detected: {result.conflict_count}")
print("Confidence Ratings: 5=High, 4=Medium, 3=Low, 2=Very Low, 1=Speculative\n")

# Access detailed conflict information as a pre-computed DataFrame
if result.conflict_count > 0:
    conflict_details_df = result.conflict_details
    display(conflict_details_df)
else:
    print("No conflict details to display.")
以下示例显示了冲突检测输出、关联的问题和 SQL,以及每个检测到的冲突的置信度。

了解验证器分值
在示例查询上运行验证程序时,它会为每个示例生成三个关键分数: Clarity、 Relatedness 和 Mapping。 这些分数派生自自然语言问题和 SQL 查询与最佳做法的一致程度。
清晰
衡量自然语言问题是否 清晰明确。 问题应是具体的,包括必要的指标、时间范围和筛选器,并避免模糊或多意向措辞。示例 – 良好: “按区域划分的 2024 年总收入。
示例 - 需要改进: “显示性能。”相关性
评估 SQL 查询与 自然语言问题意图的匹配程度。 SQL 应返回正确的指标,应用适当的筛选器,并匹配请求的粒度。示例 – 良好: 问题询问2025 年 3 月 的客户数量 → 使用 SQL
WHERE month='2025-03'对客户进行计数。
示例 - 需要改进: 问题询问 计数,但 SQL 返回 SUM(收入) 或筛选不同的时间段。映射
检查 自然语言问题中的所有文本是否显示在 SQL 查询中。 问题中提到的每个数字、日期或类别都应在 SQL 中显式表示。示例 – 良好: “2025年3月,‘西部’订单超过 100 个” → SQL 包含
> 100,2025-03和'West'。
示例 - 需要改进: SQL 缺少其中一个文本(例如,没有月筛选器)。
仅当所有三个分数(清晰度、相关度和映射)都是积极的时,才会将一个示例视为高质量。 使用这些分数来优化示例查询:重写不清楚的问题,使 SQL 与问题意向更紧密地对齐,并确保问题中的每个文本都出现在 SQL 查询中。 此迭代过程可帮助数据代理从更好的模式中学习并生成更准确的结果。